多平台文章采集系统「文章拾取器」的设计与实现
一种本地私有化、面向静态博客(Hugo)的内容拾取架构
摘要
在个人知识管理与技术写作场景中,作者常需将分布在微信、头条、CSDN、掘金、知乎等平台上的优质文章采集到本地博客体系。现有通用采集工具多为云端服务,存在数据外泄、平台适配僵化、反爬能力薄弱等问题。本文介绍一种本地私有化、数据自持的多平台文章采集系统「文章拾取器(Article Crawler)」。系统采用分层架构,将采集、转换、存储、输出解耦;设计了一套下沉到抓取层的自适应反爬框架,在不引入代理池的前提下以「域名节流 + UA 轮换 + 冷却退避」三级降级应对 IP 级风控;并以「解析器注册模式」实现平台的可插拔扩展。实践表明,该系统能够稳定地将多平台文章转化为符合 Hugo Page Bundle 规范的本地内容,并在真实网络环境下通过 CSDN、知乎等强反爬站点的采集验证。
1 引言
1.1 背景
技术写作者普遍使用静态站点生成器(如 Hugo)构建个人博客。然而,大量值得沉淀的内容散落在各大内容平台。人工复制存在三大痛点:(1)格式损耗——富文本到 Markdown 的转换易丢失结构与图片;(2)平台墙——各站 DOM 结构迥异,且普遍部署 WAF/风控,直接请求常被拦截;(3)数据主权——云端采集工具要求上传 URL 与内容,存在隐私顾虑。
1.2 目标
本系统立项目标可归纳为:
- G1 本地自持:完全本地运行,数据落 SQLite,不依赖任何云端;
- G2 多平台覆盖:自动识别主流平台并完成正文抽取;
- G3 反爬鲁棒:对 IP 级速率/冷却型风控具备自适应降级能力;
- G4 输出即发布:直接产出 Hugo Page Bundle,可指向博客静态目录;
- G5 可运维:采集参数、反爬策略外置配置,调优不改代码。
2 系统总体架构
系统遵循关注点分离原则,自上而下分为六层(见图 1):
┌─────────────────────────────────────────────┐
│ 表现层  Vite 原生 SPA(阅读 / 编辑 / 管理 UI)  │
├─────────────────────────────────────────────┤
│ 服务层  FastAPI + WebSocket(REST + 实时进度) │
├──────────────┬──────────────┬──────────────┤
│ 采集层        │ 转换层         │ 输出层        │
│ fetcher       │ html2md       │ hugo(单向同步) │
│ parsers       │ images        │ image_sync    │
│ renderer      │ keywords(TFIDF)│ slug          │
├──────────────┴──────────────┴──────────────┤
│ 存储层  aiosqlite(articles/images/tags/      │
│         content_hashes/tasks)                │
└─────────────────────────────────────────────┘
图 1 系统分层架构- 表现层:Vite 仅接管热更新与构建(内容哈希,天然缓存破坏),应用逻辑为零依赖原生 JS;无构建产物时回退静态目录。
- 服务层:FastAPI 单进程常驻,REST 提供全部读写能力,WebSocket 推送任务进度(含反爬冷却状态)。
- 采集层:负责「拿到干净正文」,是架构中对抗反爬的核心。
- 转换层:负责「转成标准 Markdown + 本地化资源 + 抽取关键词」。
- 输出层:负责「落地为可发布的 Hugo 内容包」。
- 存储层:SQLite 单文件数据库,作为唯一事实源(Source of Truth)。
3 核心架构设计
3.1 解析器注册模式(平台可插拔)
所有平台解析器继承 BaseParser,实现 match()(URL 识别)与 parse()(正文抽取)。系统维护 PARSERS 注册表,pick_parser(url) 依序匹配,未命中则回退「通用解析器」。该模式带来两点收益:单平台 bug 隔离修复、新渠道仅需新增一个子类并注册,无需改动调度与存储逻辑。
3.2 自适应反爬框架(架构核心)
真实诊断显示,CSDN 类 WAF 属IP 级速率/冷却型——桌面 UA 与高频请求被拦(返回 521 安全验证页),冷却数十秒后恢复,而移动端 UA 通过率显著更高;知乎则以 403 返回 JS 挑战页。因此反爬逻辑被下沉到抓取层 fetcher.py,而非散落在各解析器,形成三级降级:
- 域名节流:同域名两次请求至少间隔
min_gap秒; - UA 轮换:解析器定制 UA → 移动 UA → 搜索引擎爬虫 UA;
- 冷却退避:命中风控后等待
cooldown秒,换 UA 重试;全部失败抛BlockedError快速失败。
一个关键设计判断是:403 不被视为硬拦截——它可能是知乎的 JS 挑战页,需把正文交给无头渲染器处理。因此「是否拦截」以高特异 WAF_MARKERS(如「请进行安全验证」「Just a moment」)为主判据,状态码仅对 5xx/429/521 生效。所有参数(间隔、冷却、UA 顺序)外置于 config.yaml,可按域名覆盖(如 CSDN 移动 UA 优先,省去一次无效冷却)。
3.3 输出单向同步与图片可逆方案
Web 端编辑正文后单向回写 index.md,Front Matter 全量重生成,保证博客侧始终为最新真值。针对「从正文删图后计数/封面失真(幽灵封面)」问题,设计 _orphan 可逆方案:不再被正文引用的图片移入 images/_orphan/(删 DB 记录),若后续重新引用则自动移回补记,同步刷新 image_count 与封面(取 images 表最小 seq)。删除文章则级联清理 images/tags/content_hashes,并以指纹解除支持重采。
3.4 任务生命周期守卫
任务队列并发执行(默认 5),状态机覆盖 pending→…→done/failed/duplicate/skipped。删除操作设终态守卫:仅终态任务可删,进行中返回 409,避免砍断运行中的流水线;命中风控时前端以琥珀色「冷却中」徽标区分于错误(见图 2)。
4 实现的功能
系统已实现的功能可归纳为五类:
- 多平台采集:微信 / 头条 / CSDN / 掘金 / 知乎 / 通用,自动识别并抽取标题、作者、时间、正文;知乎经浏览器渲染绕过挑战,CSDN 经移动 UA 绕过高频拦截。
- 任务队列:并发采集、WebSocket 实时进度、单任务与批量重试、终态清空、反爬冷却可视化提示。
- 文章库管理:阅读器(三模板)、正文编辑回写、标签采纳/移除/添加、ZIP 导出、关键词重提取、图片与封面一致性维护。
- 批量管理:多选 + 平台/标签筛选的批量删除(
ids / platform / tag三种模式)。 - 设置与导出:输出根路径、目录布局、文件名规则、TF-IDF 关键词阈值、并发/超时/重试/反爬参数全部可配;导出 Hugo Page Bundle(
{slug}/index.md + images/*)。
4.1 主要界面
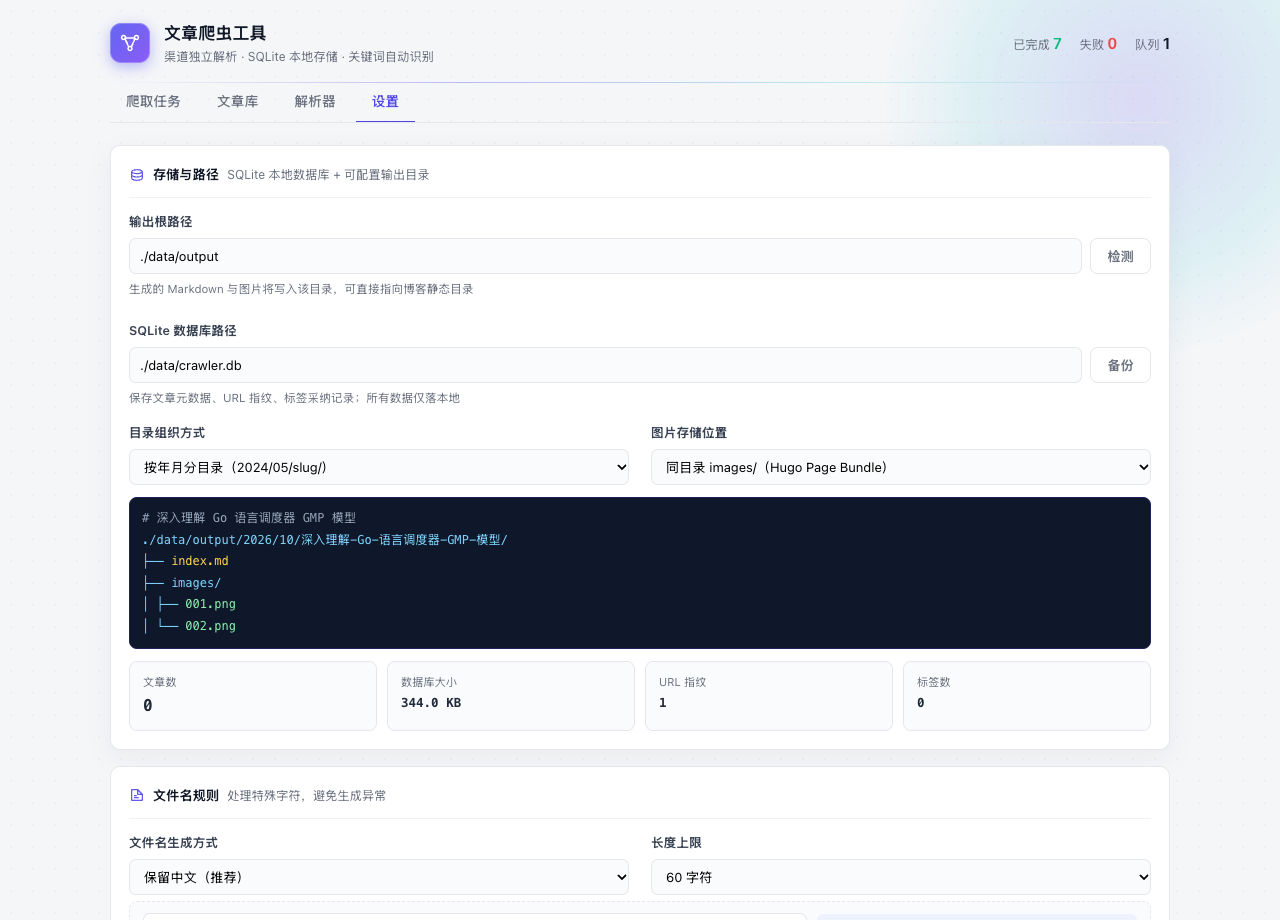
系统界面围绕「采集 → 管理 → 发布」的工作流组织为四个页签(爬取任务 / 文章库 / 解析器 / 设置),主要界面如图 2–图 6 所示(均为运行中的真实截图)。
图 2 爬取任务界面:顶部全局状态栏(已完成 / 失败 / 队列);主体为多行 URL 粘贴区(自动匹配解析器与文章分支)与任务队列实时进度列表。图中可见一条 CSDN 任务正处于「反爬冷却中:已触发风控(HTTP 521),等待 30s 后换 UA 重试(第 2/3 次)」状态,直观呈现 3.2 节自适应反爬框架的运行时表现。
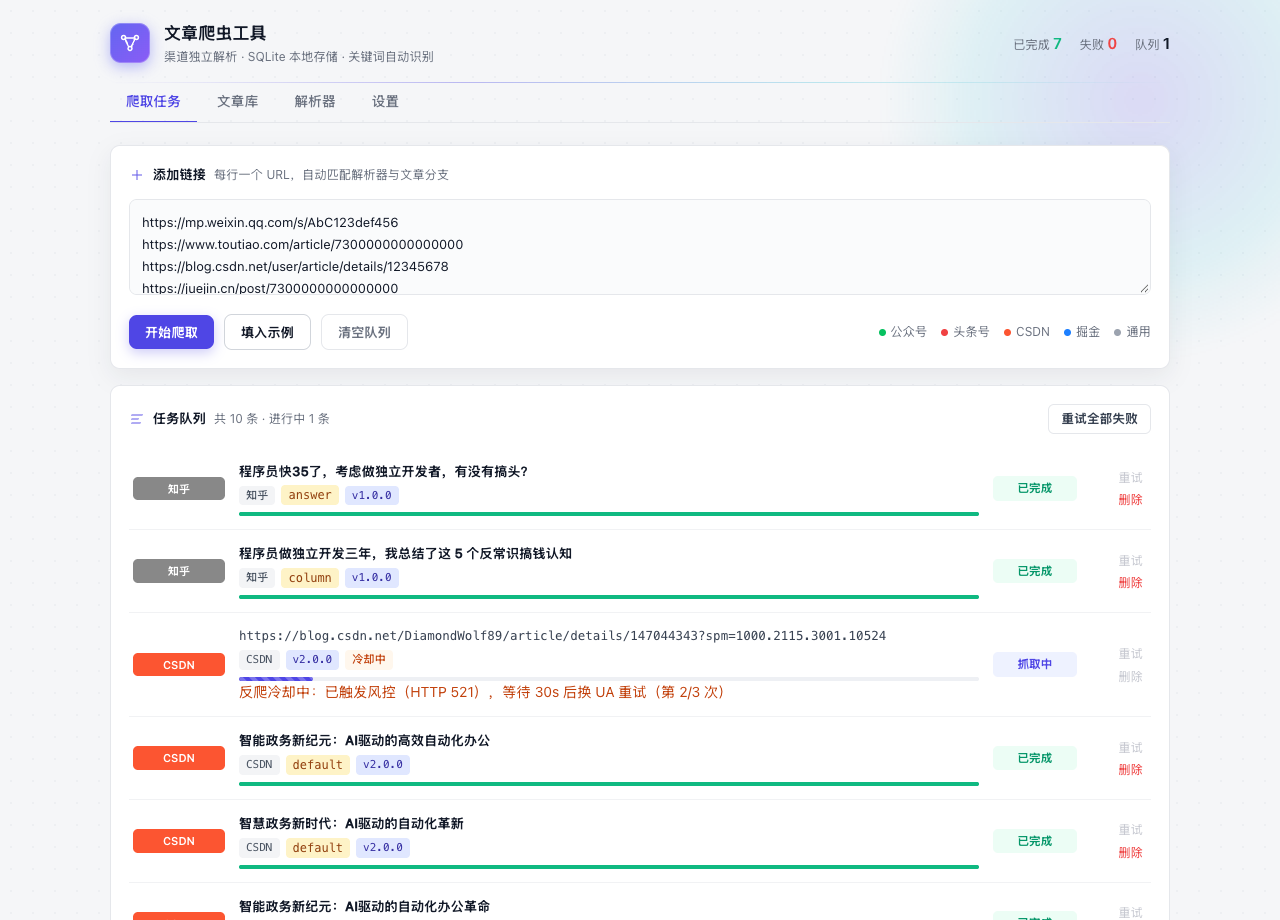
图 3 文章库界面:卡片网格展示已采集文章,含平台徽标(知乎 / CSDN / 头条 / 微信)、封面、图片计数、标签与 ZIP 下载入口;顶部提供搜索、平台筛选与批量删除,对应 3.3 节文章管理与批量操作能力。
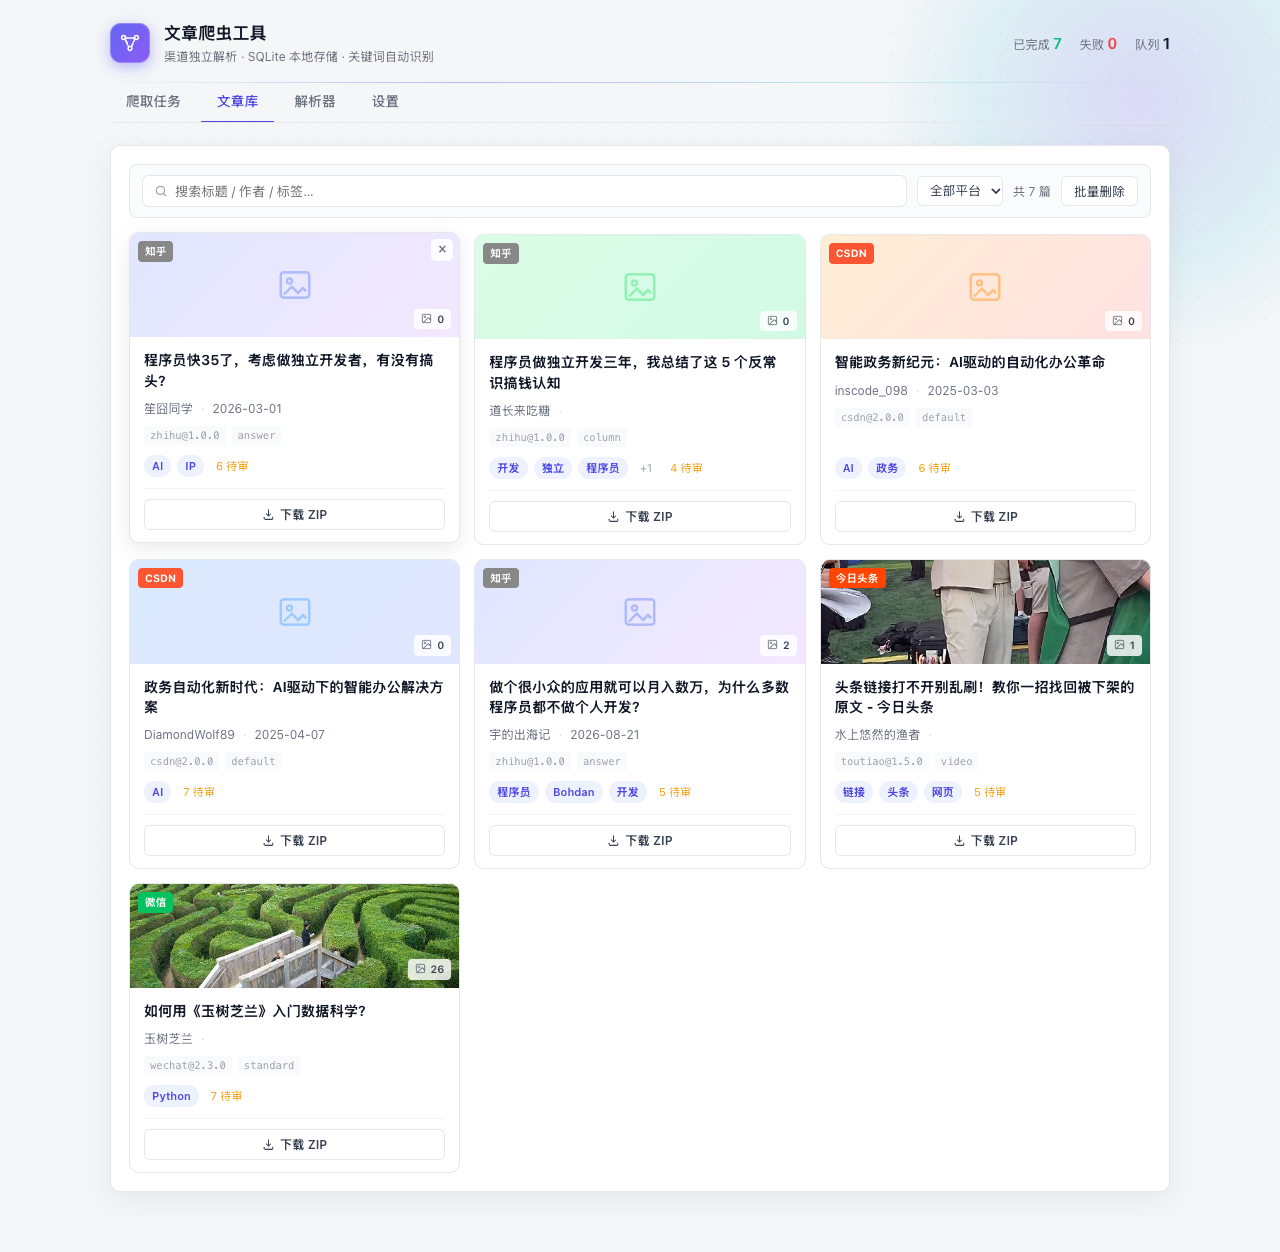
图 4 阅读器界面:正文渲染视图,支持三种排版模板切换、源码编辑与 ZIP 导出;标签区展示 TF-IDF 候选词及置信度,支持采纳(实心)/移除/手动添加与重新识别,对应「关键词人工辅助审核」设计。
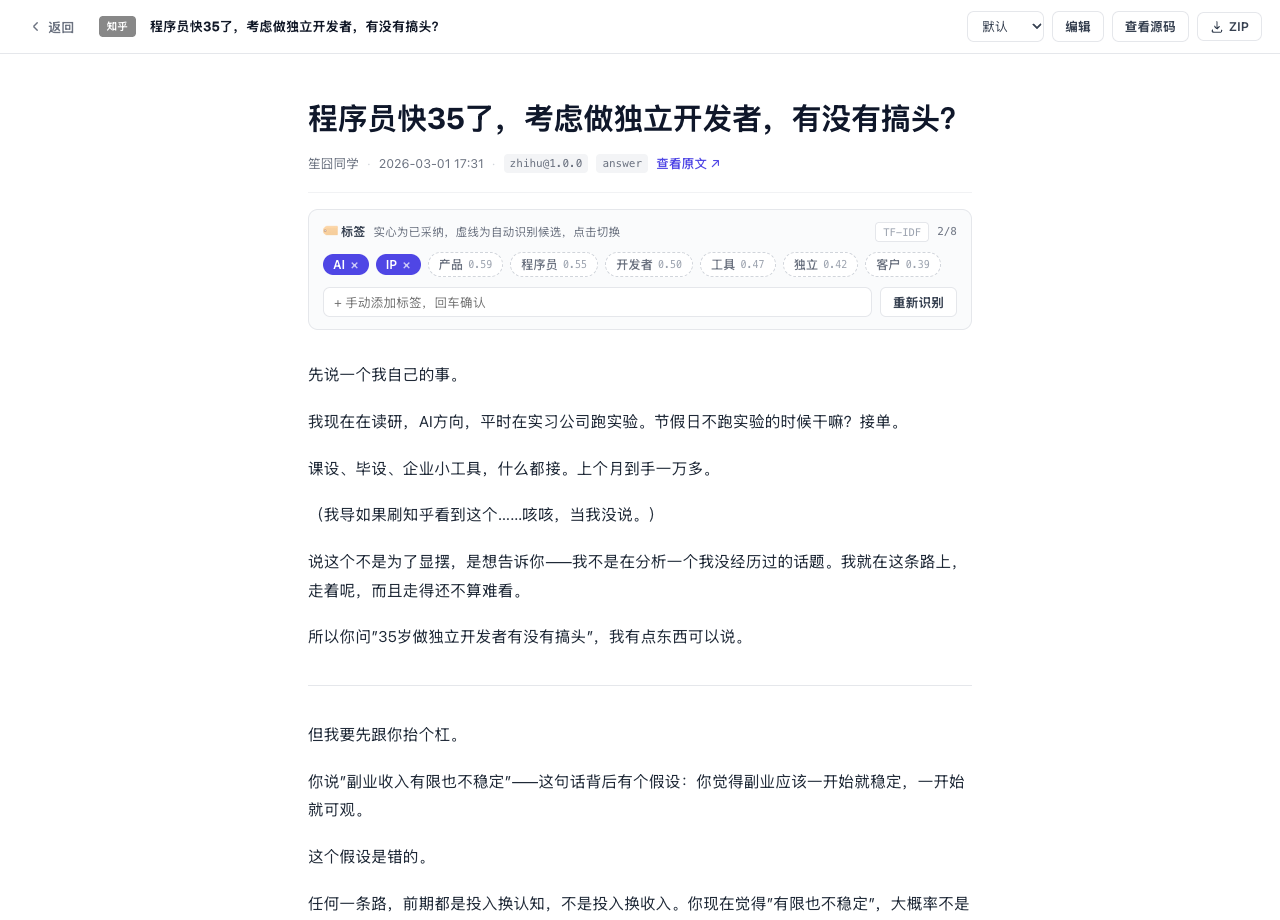
图 5 解析器界面:列出各平台解析器的 key / 名称 / 版本 / 分支说明,是 3.1 节解析器注册模式的可观测入口,便于单平台排查与版本追踪。
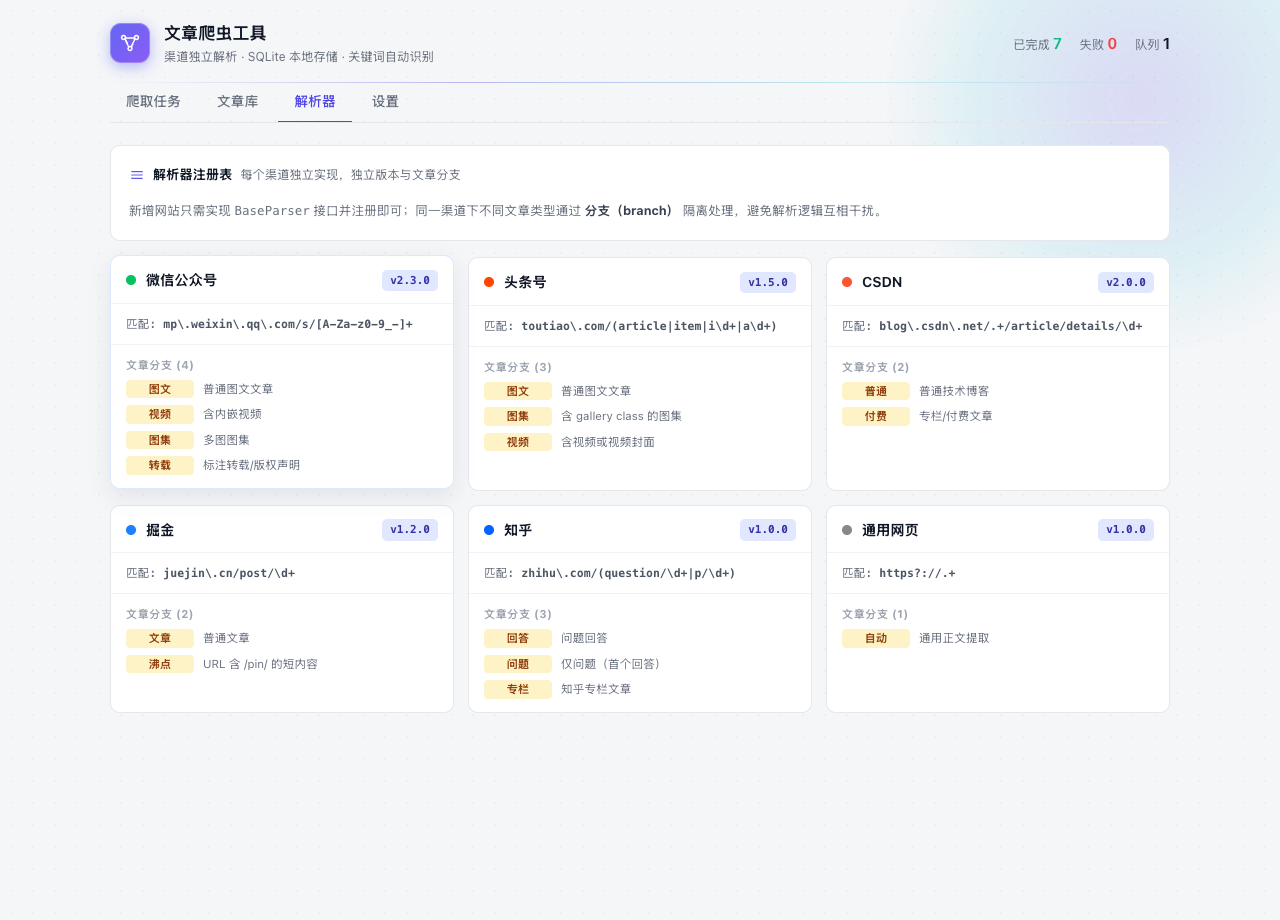
图 6 设置界面:输出根路径(含可用性检测)、数据库路径、目录布局、文件名规则、关键词算法与阈值、反爬参数等全部外置可配,对应 3.2 节「参数外置 config.yaml」的 G5 可运维目标。
5 达到的目标与验证
对照引言中的目标,系统达成情况如下:
- G1 本地自持:✅ 数据全落本地 SQLite 与文件系统,关键词计算不外传。
- G2 多平台覆盖:✅ 6 类渠道自动识别,失败回退通用解析器。
- G3 反爬鲁棒:✅ 自适应框架实测将 CSDN 采集从「每次必等 30s 冷却」降至「无冷却即通过」;知乎挑战页经渲染稳定解析。
- G4 输出即发布:✅ 直接产出符合 Hugo 规范的 Page Bundle。
- G5 可运维:✅ 反爬与采集参数全部外置配置。
质量验证采用三层:单元测试 51 passed(覆盖解析、抓取、转换、调度、图片同步、批量删除等);Playwright 真浏览器驱动系统 Chrome、pageerror = 0;以及实网采集验证(CSDN 批量 5/5 完成,知乎无回归)。
6 总结与展望
本文从架构视角呈现了「文章拾取器」的设计与实现。其核心价值在于两点工程取舍:(1)把反爬作为横切关注点下沉到抓取层,以统一的三级降级而非逐站补丁应对风控,并以「403 非硬拦截」的判断避免了误伤正常挑战页;(2)以单一 SQLite + 单向文件同步确立数据真值,配合可逆的图片孤儿方案,在「自动化」与「可撤销」之间取得平衡。
后续可演进方向包括:引入回收站机制以弥补删除不可逆;接入代理池进一步增强反爬弹性;以及预留的本地 FTS5 + LLM 会话式检索能力,使采集沉淀的内容可被自然语言问答。